Métricas de visibilidade em IA
Presença, Citation Share, recomendação, precisão e share of voice: definições, fórmulas, intervalo de confiança e um exemplo numérico completo.
Neste texto
Que métricas o Citation Share usa?
O método separa o que a IA diz, o que ela cita e o que ela recomenda. Esses eventos têm causas diferentes. Uma resposta pode nomear a marca sem citar o site, citar o site sem nomear a marca ou listar a marca sem recomendá-la. Misturar tudo em uma "taxa de aparição" esconde o diagnóstico.
| Métrica | Definição | Fórmula | Base |
|---|---|---|---|
| Presença | respostas que nomeiam a marca no texto | menções ÷ respostas válidas | todas as consultas |
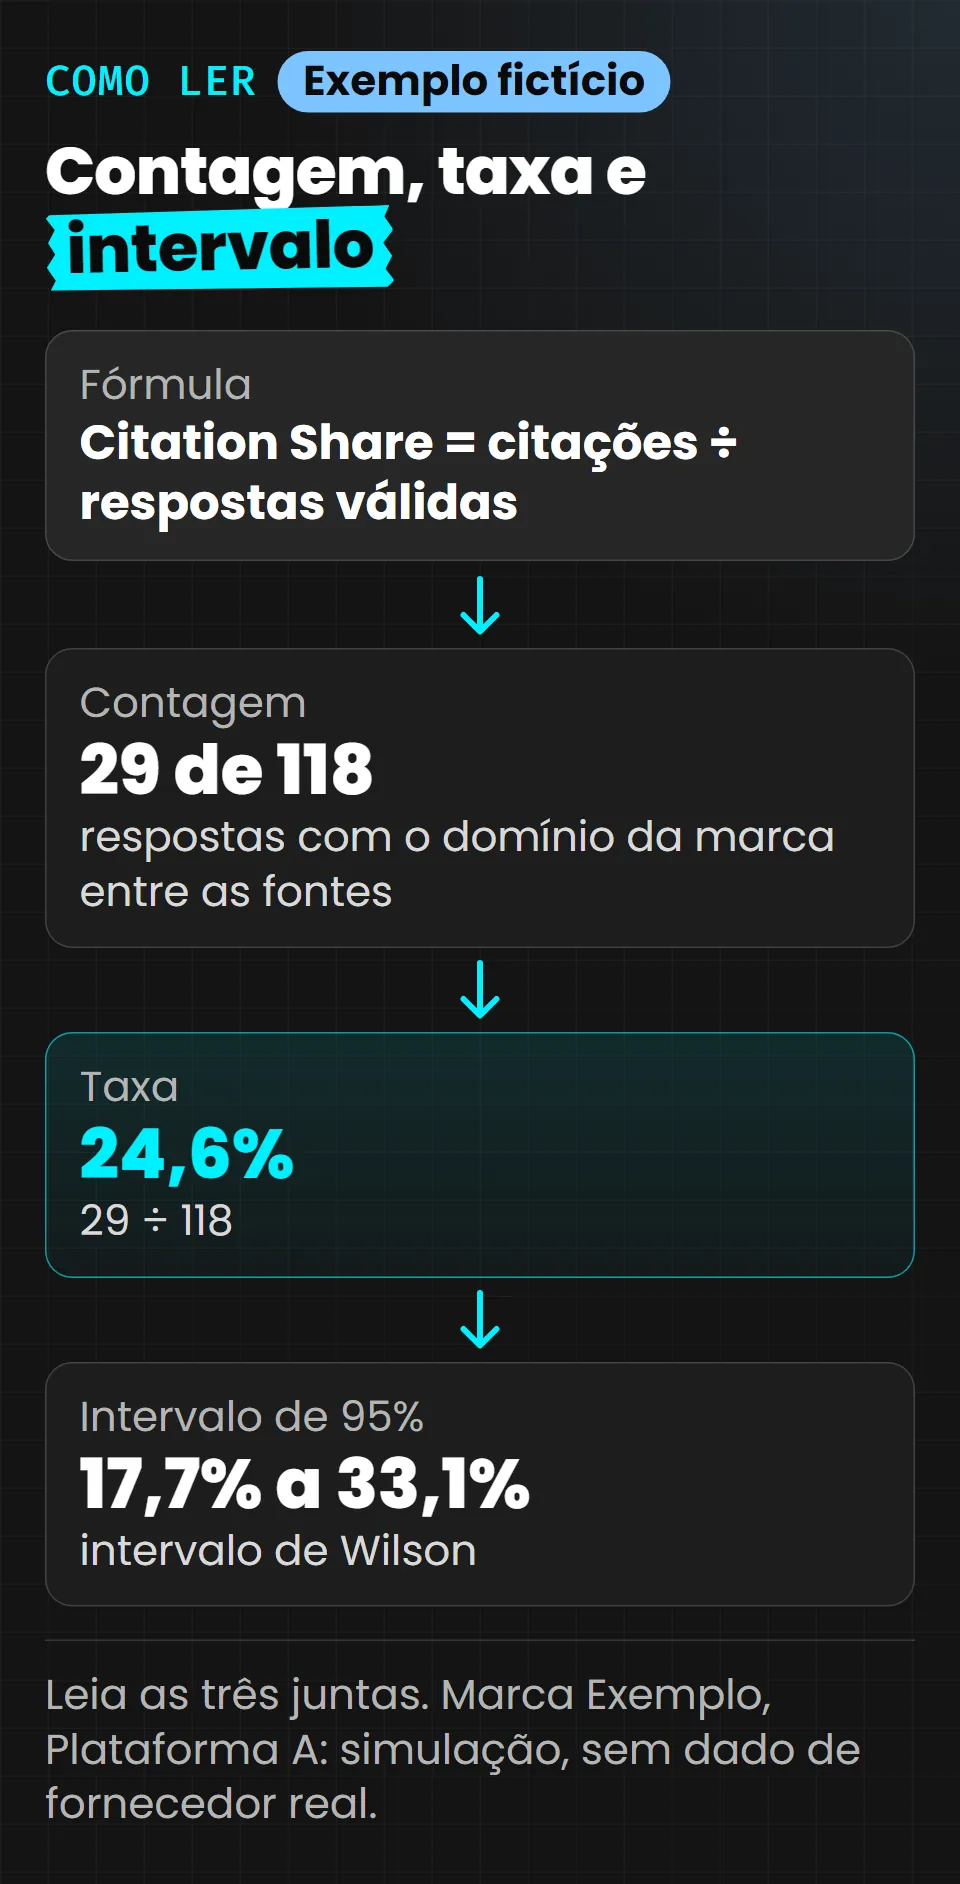
| Citation Share (taxa) | respostas em que o domínio da marca está entre as fontes | citações ÷ respostas válidas | todas as consultas |
| Citation Share competitivo | parte das citações do conjunto que pertence à marca | citações da marca ÷ soma das citações de todas as marcas | marcas do conjunto |
| Recomendação | respostas que indicam a marca como opção adequada | recomendações ÷ respostas de decisão | consultas de decisão |
| Precisão | menções cuja descrição está correta | menções corretas ÷ menções | respostas com menção |
| Share of voice em IA | parte da marca nas menções do conjunto | menções da marca ÷ soma das menções de todas as marcas | marcas do conjunto |
"Resposta válida" é a que teve conteúdo completo para uma pergunta válida. Saem da conta os erros e as respostas vazias. "Domínio da marca" inclui os subdomínios listados no escopo. As regras de classificação, com casos-limite, estão no protocolo.
Share of voice é um conceito de marketing, anterior às IAs, que mede a participação de uma marca entre concorrentes. Aqui ele foi adaptado para respostas de IA e conta menções. O Citation Share, na formulação de Camillo Dantas, conta fontes. É por isso que os dois podem divergir.
Como a unidade de análise muda o número?
Há duas unidades. Na unidade resposta, cada resposta válida vale um. Na unidade consulta, a consulta vale um e conta como "citada" quando o domínio aparece em pelo menos metade das suas execuções válidas. A primeira usa mais dados e dá intervalos mais estreitos. A segunda é mais honesta quando a mesma consulta é repetida, porque as respostas de uma mesma consulta se parecem e não são independentes.
O método recomenda calcular as duas e publicar o intervalo da unidade consulta. A taxa pode ser diferente em cada unidade, e isso é esperado: uma consulta com uma única citação em três execuções conta na unidade resposta, mas não na unidade consulta.
Como calcular o intervalo de confiança?
Toda taxa é uma proporção observada em uma amostra. O intervalo de confiança mostra quanto ela poderia variar se a coleta fosse refeita. O método usa o intervalo de Wilson de 95%, que se comporta bem com amostras pequenas e taxas perto de 0% ou 100%. Brown, Cai e DasGupta (2001) mostram que o intervalo padrão, de Wald, tem cobertura instável nesses casos e recomendam o de Wilson, o de Jeffreys ou o de Agresti-Coull.
k = respostas que cumprem o critério;  n = respostas na base;  p = k / n;  z = 1,96

centro        = (p + z² / (2n)) / (1 + z² / n)
meia-largura  = z × √( p(1 − p) / n + z² / (4n²) ) / (1 + z² / n)
intervalo     = centro ± meia-largura
Para a diferença entre duas medições independentes, o método usa a combinação de intervalos de Wilson proposta por Newcombe (1998, método 10). Com p1 e p2 as taxas e (l1, u1), (l2, u2) os limites de cada uma:
d      = p1 − p2
inf    = d − √( (p1 − l1)² + (u2 − p2)² )
sup    = d + √( (u1 − p1)² + (p2 − l2)² )
Se o intervalo da diferença inclui zero, não se pode afirmar mudança. A calculadora aplica as duas fórmulas.
Que exemplo numérico mostra o cálculo completo?
Este exemplo é uma simulação, com marca e plataforma fictícias. Nenhum número descreve um fornecedor real. A "Marca Exemplo" tem 40 consultas, 12 delas de decisão, executadas 3 vezes cada na "Plataforma A".
| Item | Valor |
|---|---|
| Respostas coletadas | 40 × 3 = 120 |
| Respostas inválidas | 2 (ambas em consultas que não são de decisão) |
| Respostas válidas (n) | 118 |
| Respostas com a marca nomeada | 47 |
| Respostas com o domínio da marca nas fontes | 29 |
| Respostas de consultas de decisão | 12 × 3 = 36 |
| Dessas, com a marca recomendada | 18 |
| Menções com informação correta | 41 de 47 |
Resultados por resposta, com intervalo de Wilson de 95%:
| Métrica | Cálculo | Taxa | Intervalo |
|---|---|---|---|
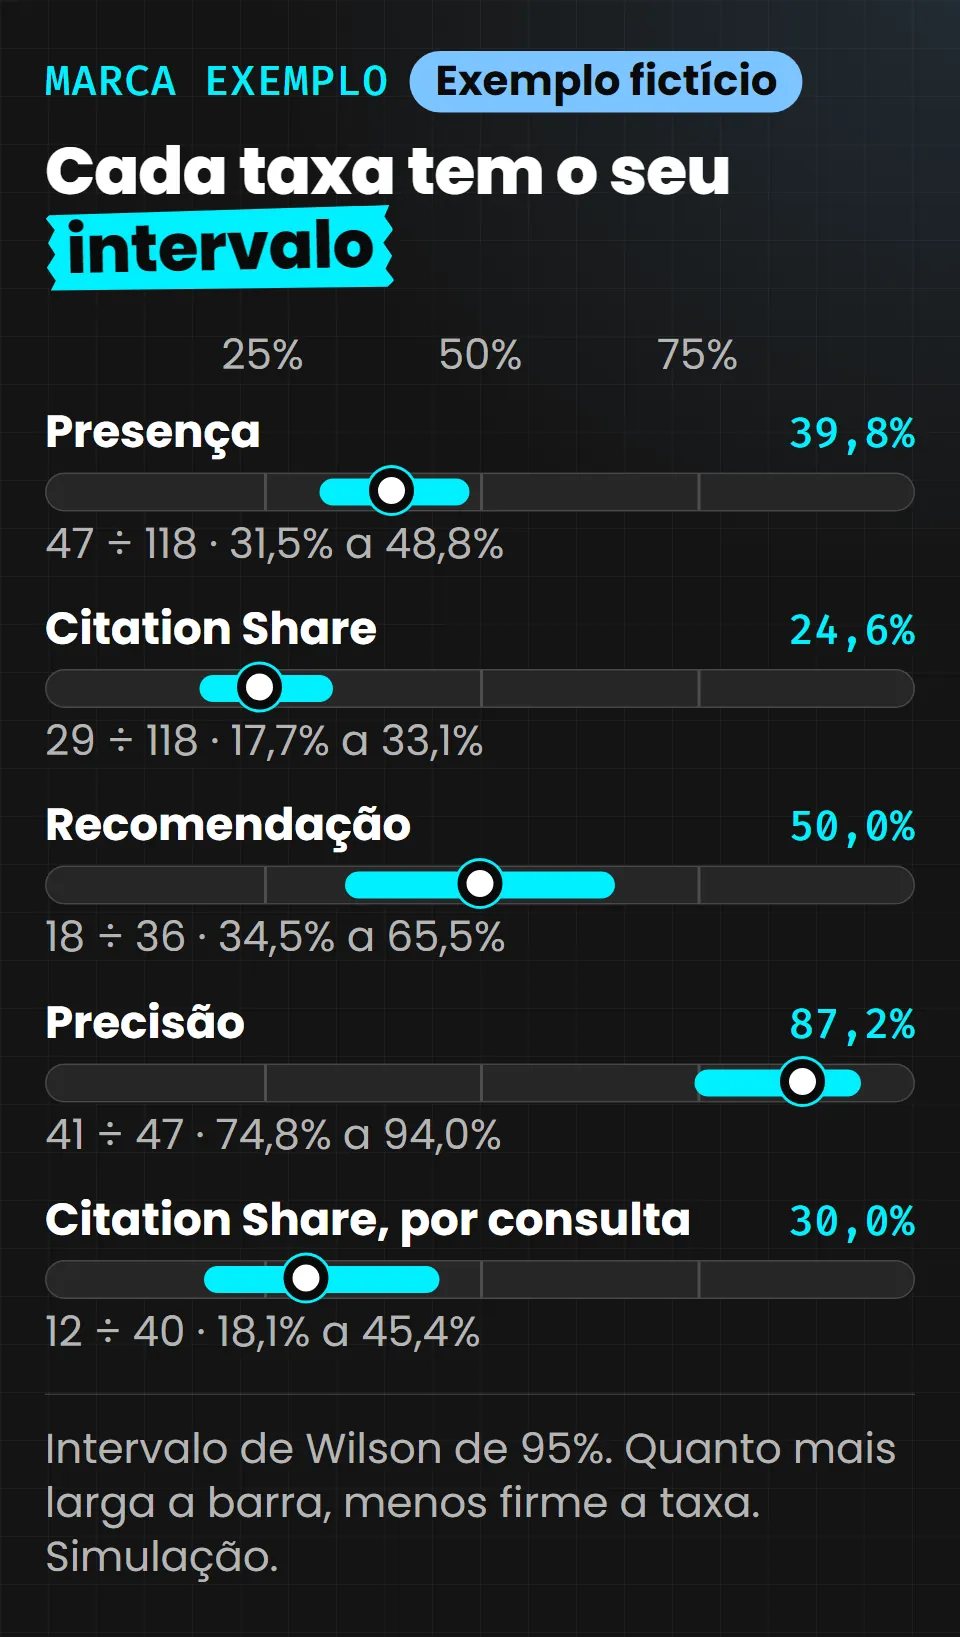
| Presença | 47 ÷ 118 | 39,8% | 31,5% a 48,8% |
| Citation Share | 29 ÷ 118 | 24,6% | 17,7% a 33,1% |
| Recomendação | 18 ÷ 36 | 50,0% | 34,5% a 65,5% |
| Precisão | 41 ÷ 47 | 87,2% | 74,8% a 94,0% |
Na unidade consulta, 12 das 40 consultas tiveram o domínio citado em ao menos 2 das 3 execuções: 30,0%, com intervalo de 18,1% a 45,4%. O intervalo é bem mais largo, porque a base caiu de 118 respostas para 40 consultas. É o valor que deve aparecer em relatório.
Agora o conjunto competitivo. Três concorrentes fictícios foram medidos nas mesmas respostas:
| Marca | Menções | Share of voice | Citações | Citation Share competitivo |
|---|---|---|---|---|
| Marca Exemplo | 47 | 31,3% | 29 | 27,1% |
| Concorrente A | 52 | 34,7% | 41 | 38,3% |
| Concorrente B | 30 | 20,0% | 22 | 20,6% |
| Concorrente C | 21 | 14,0% | 15 | 14,0% |
| Total | 150 | 100% | 107 | 100% |
A soma das citações (107) não é o número de respostas: uma resposta pode citar mais de uma marca ou nenhuma. Por isso a divisão usa a soma das citações do conjunto, e não n. Na leitura, a Marca Exemplo tem 31,3% das menções e 27,1% das citações: é nomeada um pouco mais do que é usada como fonte.
Resta a comparação com uma linha de base fictícia da mesma plataforma e do mesmo conjunto, medida meses antes: 13 citações em 115 respostas válidas (11,3%, intervalo de 6,7% a 18,4%). A diferença para a medição atual é de +13,3 pontos percentuais, com intervalo de 95% de +3,4 a +22,9. O intervalo não inclui zero. Há apoio estatístico para dizer que a taxa subiu. Há também um aviso: o limite inferior é de apenas 3,4 pontos, e o limite superior, de quase 23. A mudança pode ser pequena ou grande.
Como interpretar combinações de métricas?
| Padrão | Leitura provável | Camada a examinar |
|---|---|---|
| Presença alta, Citation Share baixo | a IA conhece a marca, mas não usa o site como fonte | estrutura e prova |
| Presença baixa em consultas sem o nome da marca | falta conteúdo que responda à pergunta | editorial |
| Citada, mas pouco recomendada | falta evidência para sustentar a indicação | prova |
| Precisão baixa nas consultas com o nome da marca | descrições erradas ou desatualizadas circulando | identidade e distribuição semântica |
| Share of voice alto, Citation Share competitivo baixo | a marca é comentada, mas as fontes vêm de terceiros | distribuição semântica |
| Taxas boas em uma plataforma e fracas em outra | cada plataforma escolhe fontes de modo próprio | plataformas |
Essas leituras são hipóteses de trabalho. Verifique cada uma com a medição seguinte, depois de agir sobre a camada.
Por que o método não mede posição na resposta?
Porque a posição em uma resposta de IA é instável. O estudo da SparkToro e da Gumshoe.ai (estudo de fornecedor, não revisado por pares, 2.961 execuções) relatou menos de 1 chance em 100 de repetição da mesma lista de marcas e cerca de 1 em 1.000 de repetição na mesma ordem, e os autores concluem que a porcentagem de visibilidade em muitas consultas é mais estável que a posição. O Citation Share segue esse caminho: mede frações de um conjunto, não colocações.
Que erros de cálculo aparecem com mais frequência?
- Misturar plataformas na mesma base. Cada plataforma tem a sua linha.
- Dividir recomendação por todas as respostas. A base é só a das consultas de decisão.
- Contar respostas inválidas no denominador. Elas saem da conta, e a quantidade delas deve ser publicada.
- Chamar de Citation Share o que é presença. Nome no texto não é fonte citada.
- Comparar taxas sem olhar o intervalo. Duas taxas de 24% e 31% com 118 respostas cada não são distinguíveis.
- Usar metas copiadas. Não há nível de Citation Share que sirva de referência universal. Compare a marca com a própria linha de base e com os concorrentes do mesmo conjunto.
Perguntas frequentes
Qual é a fórmula do Citation Share?
Citation Share (taxa) é o número de respostas válidas que trazem o domínio da marca entre as fontes dividido pelo número de respostas válidas, calculado por plataforma e multiplicado por 100 para virar porcentagem. A versão competitiva divide as citações da marca pela soma das citações de todas as marcas do conjunto.
Citation Share e share of voice são a mesma coisa?
Não. Share of voice, neste método, conta menções do nome da marca entre as marcas do conjunto. Citation Share conta respostas em que o domínio é fonte. A marca pode ser muito mencionada e pouco citada. Medir as duas mostra se a IA fala da marca ou também usa o site como base.
Por que usar o intervalo de Wilson e não a margem de erro comum?
A margem comum usa o intervalo de Wald, que pode ser instável com amostras pequenas e taxas perto de 0% ou 100%, segundo Brown, Cai e DasGupta (2001). O de Wilson mantém cobertura mais estável nessas situações, e é por isso que o método o adota.
Posso somar as citações de todas as plataformas em um número único?
Pode somar, mas não deve apresentar como indicador principal. As plataformas selecionam e exibem fontes de modos diferentes, e a soma esconde onde a marca vai bem ou mal. Publique uma linha por plataforma e, se quiser um resumo, mostre as linhas lado a lado.
Qual é um Citation Share bom?
Não existe referência universal, porque depende do mercado, das consultas e dos concorrentes. Use a própria linha de base e os concorrentes do mesmo conjunto como comparação. Desconfie de metas fixas copiadas de outros contextos, sem fonte.
O que significa o intervalo da diferença incluir zero?
Significa que, com a amostra que você tem, não dá para separar uma mudança real de oscilação da coleta. A conclusão correta é "sem evidência de mudança". Para saber mais, amplie o número de consultas e repita a medição.
Onde aplicar estas fórmulas?
A calculadora de Citation Share recebe as contagens e devolve todos os números desta página. A planilha de benchmark guarda o ledger de onde as contagens saem. O método explica o desenho geral, e as cinco camadas mostram o que fazer com o diagnóstico.
Fontes
- Interval Estimation for a Binomial Proportion (Brown, Cai e DasGupta), Statistical Science, vol. 16, n. 2, p. 101-133 (2001)
- Interval estimation for the difference between independent proportions (Newcombe, 1998), método 10, Statistics in Medicine, vol. 17, p. 873-890; conferido na documentação do pacote Epi (1998)
- AIs are highly inconsistent when recommending brands or products (estudo de fornecedor, não revisado por pares), SparkToro e Gumshoe.ai (2026-01-28)
Meça antes de otimizar
Defina o conjunto de consultas, registre a linha de base e acompanhe a evolução com o mesmo protocolo.