As 5 camadas do Citation Share
Identidade, editorial, estrutura, prova e distribuição semântica: o modelo de diagnóstico que liga o resultado da medição ao que a marca pode mudar.
Neste texto
O que são as cinco camadas?
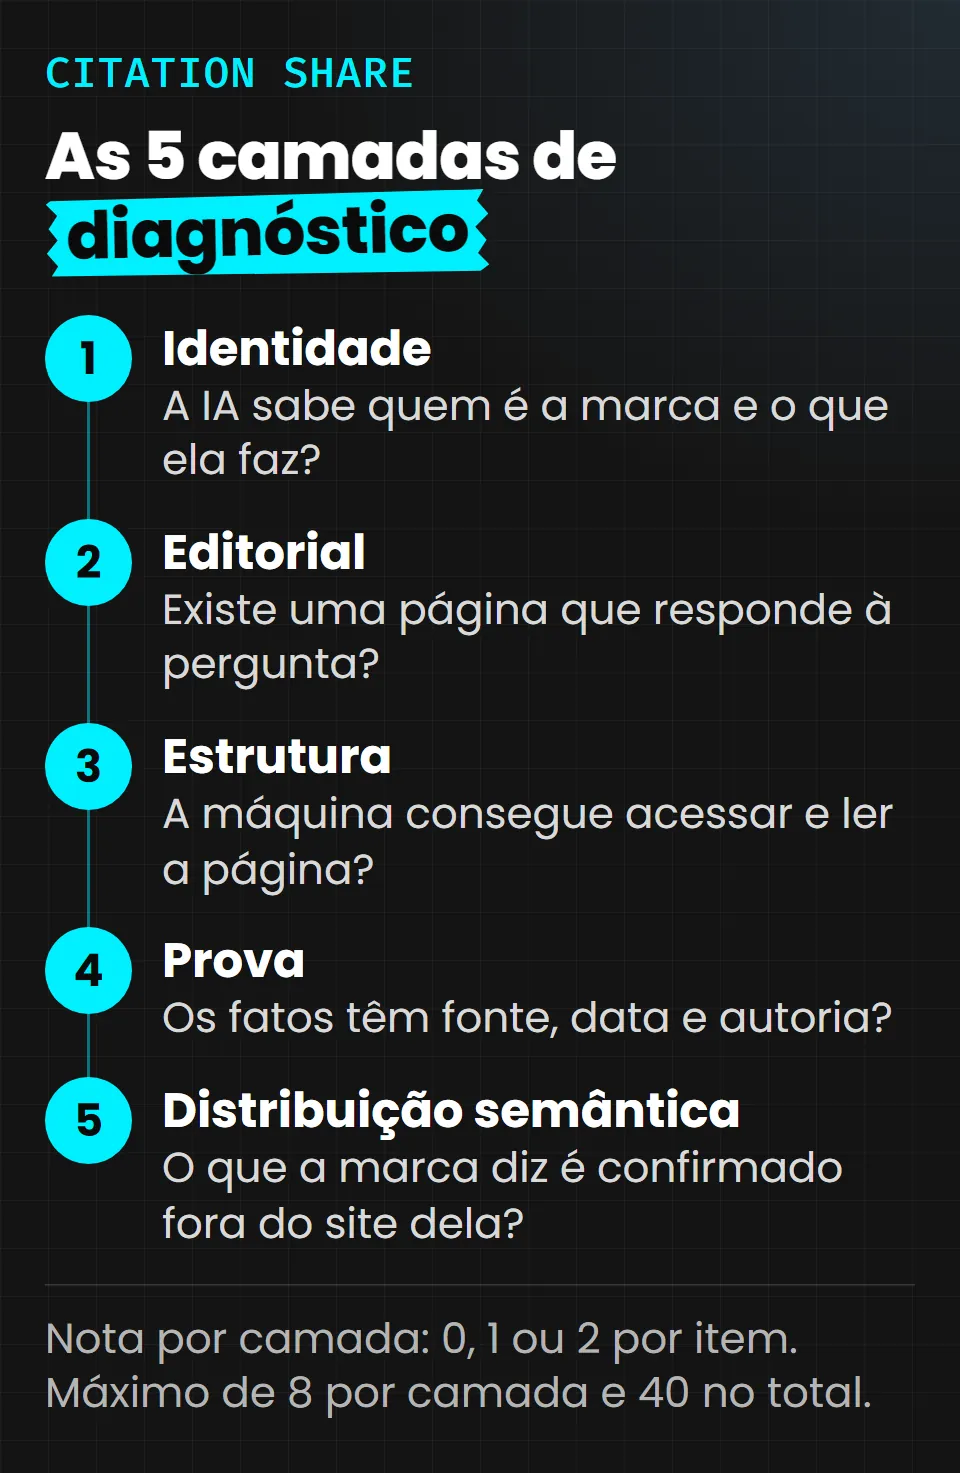
A medição do Citation Share diz quanto a marca aparece. Não diz por quê. As cinco camadas preenchem essa lacuna. Cada camada é um conjunto de condições que, quando faltam, deixam a marca fora da resposta ou a deixam mal descrita. São um modelo de trabalho de Camillo Dantas, de autoria declarada por ele, e funcionam como lista de verificação: não são uma lei do funcionamento das plataformas. Nenhuma plataforma de IA publica a receita pela qual escolhe fontes, e este site não finge conhecer o interior desses sistemas.
O modelo parte de uma constatação que vale para qualquer sistema de resposta com busca: para citar um site, a IA precisa encontrá-lo, entender de quem ele fala, extrair uma resposta e confiar no que lê. Cada uma dessas exigências aparece em uma ou mais camadas. A ordem abaixo vai do mais interno (a marca) ao mais externo (o lugar da marca na web).
| Camada | Pergunta de diagnóstico | Sintoma comum na medição |
|---|---|---|
| 1. Identidade | A IA sabe quem é a marca e o que ela faz? | descrições erradas, marca confundida com outra, baixa precisão |
| 2. Editorial | Existe uma página que responde à pergunta? | marca ausente em consultas sem o nome da marca |
| 3. Estrutura | A máquina consegue acessar e ler a página? | boa presença no texto, mas domínio fora das fontes |
| 4. Prova | Os fatos têm fonte, data e autoria? | a marca aparece, mas não é recomendada |
| 5. Distribuição semântica | O que a marca diz é confirmado fora do site dela? | citada em consultas de marca, ausente nas de descoberta |
Camada 1: identidade
O que é. A identidade é o conjunto de informações que tornam a marca uma entidade inequívoca: nome, descrição curta, endereço do site, responsáveis, categoria em que atua e perfis oficiais. Uma boa identidade responde "quem é" sem ambiguidade.
Por que importa. O Google recomenda, em sua orientação sobre conteúdo útil, que o leitor consiga saber quem criou o conteúdo, por exemplo com autoria visível e link para a origem do autor, além de como e por que foi feito. Para a IA, o raciocínio é parecido: uma marca com nome genérico, descrição inconsistente entre canais ou sem página institucional é mais difícil de descrever com precisão.
Como verificar.
- A página inicial e a página institucional descrevem a marca em uma frase igual, com nome por extenso.
- Há uma página de autoria ou de equipe com nome, função e experiência verificável.
- Nome, descrição e endereço são iguais no site, nos perfis oficiais e nos diretórios.
- Os dados estruturados de organização e pessoa, quando usados, repetem o que está no texto. A documentação do Google sobre recursos de IA afirma que não é preciso marcação especial para aparecer; o dado estruturado serve à consistência, não é requisito.
Erro comum. Usar variações do nome em cada canal (sigla, nome fantasia, razão social) sem uma página que declare que são a mesma entidade. Correção: escolha um nome canônico, liste as variações em uma página e use sempre o canônico no corpo do texto.
Como aparece na medição. Consultas com o nome da marca revelam a camada: precisão baixa e descrições trocadas. É a camada que mais afeta a métrica de precisão.
Camada 2: editorial
O que é. A camada editorial é a existência de conteúdo que responde às perguntas do cliente de modo direto e completo. Ela cobre as perguntas centrais e também as subconsultas em que um sistema de busca com IA pode dividir um pedido. A documentação do Google descreve que o AI Overviews e o AI Mode podem emitir várias buscas relacionadas por subtópico; isso torna a cobertura de subtópicos relevante. O método de cobertura de subconsultas está documentado em queryfan-out.com.
Por que importa. Quem não tem uma página que responda à pergunta não entra na resposta por mérito. Na medição, aparece como ausência nas consultas sem o nome da marca.
Como verificar.
- Para cada consulta do conjunto de medição há uma página que a responde nas duas primeiras linhas.
- A página define o termo na primeira ocorrência e usa o nome da entidade por extenso.
- Há formatos adequados à pergunta: lista para enumerações, tabela para comparação, passos para procedimentos, FAQ para dúvidas diretas.
- Uma página trata de um conceito. Páginas que tentam responder a tudo diluem a resposta.
Erro comum. Escrever para o termo e não para a pergunta, deixando a resposta no quinto parágrafo. Correção: reescreva o início com a resposta de 40 a 80 palavras e deixe o contexto para depois. O trabalho de Aggarwal e colegas sobre otimização para motores generativos (KDD 2024) relata que a eficácia de cada tática varia por domínio, e por isso vale testar e medir em vez de aplicar receita única.
Como aparece na medição. Baixa presença e baixo Citation Share nas consultas de descoberta e consideração, mesmo quando a marca vai bem nas consultas com o nome.
Camada 3: estrutura
O que é. A estrutura é a parte técnica que permite à máquina acessar, renderizar e extrair o conteúdo: página indexável, resposta presente no HTML, títulos coerentes, links internos claros, tempo de carregamento razoável e permissão de acesso aos robôs que alimentam as respostas.
Por que importa. A documentação do Google informa que, para aparecer como link de suporte em AI Overviews ou no AI Mode, a página precisa estar indexada e ser elegível para aparecer na busca com snippet, e que a inclusão não é garantida. Sem essa base, nenhuma melhoria editorial chega à resposta. A página sobre robots.txt para robôs de IA detalha a escolha de acesso por tipo de robô.
Como verificar.
- A página aparece no índice do buscador e pode exibir snippet (sem bloqueio por
noindexounosnippetindevido). - O texto da resposta está no HTML entregue ao robô, e não depende de execução de scripts para existir.
- Não há bloqueio acidental de robôs de busca no
robots.txtou no firewall. - O mapa do site está atualizado e as páginas importantes têm links internos de entrada.
Erro comum. Bloquear robôs de IA por política geral sem separar robôs de treino de robôs de busca, e depois estranhar a ausência nas respostas. Correção: decida por tipo de robô e registre a decisão, conforme a documentação de cada fornecedor.
Como aparece na medição. A marca é mencionada no texto, mas o domínio dela não aparece nas fontes. É a combinação "presença alta e Citation Share baixo".
Camada 4: prova
O que é. A prova é tudo que permite a um leitor, humano ou máquina, verificar o que a página afirma: números com fonte e data, método descrito, autoria identificada, exemplos, estudos próprios e avaliações reais exibidas na página.
Por que importa. Segundo a orientação do Google sobre conteúdo útil, entre os quatro componentes do E-E-A-T, a confiança é o mais importante, e o E-E-A-T em si não é um fator de classificação específico. Para a IA que cita, afirmações verificáveis são mais fáceis de reproduzir sem erro. Sem prova, a resposta prefere uma fonte que a tenha.
Como verificar.
- Cada número do texto tem fonte e data no mesmo parágrafo.
- Os dados próprios trazem o método, o período e a amostra.
- A autoria é visível, com link para a página do autor.
- Não há depoimento, caso ou número sem comprovação. Se for hipotético, vem com o rótulo "exemplo" ou "simulação".
Erro comum. Estatística de mercado sem origem. Correção: abra a fonte, confirme valor, data e contexto, e cite; se não conseguir, descreva a ideia sem o número.
Como aparece na medição. A marca é citada, mas não recomendada em consultas de decisão, e perde para concorrentes que exibem dados e comparações verificáveis.
Camada 5: distribuição semântica
O que é. É a presença consistente das mesmas informações sobre a marca em lugares que não são o site dela: perfis oficiais, diretórios do segmento, publicações de terceiros, repositórios, comunidades e imprensa. "Semântica" significa que o que importa é a mesma descrição e os mesmos fatos, não a quantidade de menções.
Por que importa. Plataformas com busca constroem a resposta a partir de várias fontes, e a página do próprio dono é só uma delas. Esta é a camada menos documentada pelos fornecedores: nenhuma das documentações oficiais consultadas afirma que fontes externas aumentam a chance de citação. É uma hipótese do método, e a medição testa: a página mapa de fontes mostra de quais domínios vêm as fontes citadas para cada plataforma. O método de plantio responsável de informação em fontes externas, o LLM Seeding, está em llmseeding.org.
Como verificar.
- A descrição da marca nos cinco principais lugares externos é igual à do site.
- Os perfis oficiais apontam para o site e o site aponta para eles.
- Fontes de terceiros que falam da marca têm informação correta e atual.
- Nada foi criado só para inflar menções: sem redes artificiais, depoimentos fabricados ou perfis falsos.
Erro comum. Espalhar a marca em dezenas de perfis abandonados com dados desatualizados. Correção: mantenha poucos perfis, atuais e coerentes, e remova ou corrija os antigos.
Como aparece na medição. A marca vai bem nas consultas com o nome e some nas consultas de descoberta, onde as fontes citadas vêm de portais e diretórios que não a mencionam.
Como pontuar as cinco camadas?
O quadro abaixo transforma a verificação em pontuação. Dê 0 (ausente), 1 (parcial) ou 2 (completo) a cada item. O máximo é 8 por camada e 40 no total. É uma heurística do método para priorizar o que corrigir, e não prevê citação nem foi validada por estudo independente.
| # | Camada | Itens a pontuar |
|---|---|---|
| 1 | Identidade | descrição canônica; página de autoria; consistência entre canais; dados estruturados coerentes |
| 2 | Editorial | resposta direta no início; cobertura das consultas do conjunto; formatos adequados; um conceito por página |
| 3 | Estrutura | indexável com snippet; resposta no HTML; acesso de robôs de busca; links internos e mapa do site |
| 4 | Prova | fonte e data nos números; método declarado; autoria visível; sem afirmação sem comprovação |
| 5 | Distribuição semântica | descrição igual nos perfis; perfis atuais; fontes de terceiros corretas; nada artificial |
Leia a nota junto com a medição. Uma camada com nota 3 de 8 e um sintoma claro no ledger vira prioridade. Uma camada com nota 8 de 8 e sintoma persistente indica que o problema está em outro lugar, talvez na escolha das consultas.
Que exemplo mostra o diagnóstico em ação?
Este é um exemplo hipotético, sem relação com dados reais. Uma consultoria fictícia mede 60 consultas em uma plataforma e obtém: presença de 55%, Citation Share de 12%, recomendação de 8%. O padrão "muita presença, pouca citação do domínio" aponta primeiro para a camada 3: a equipe descobre que as páginas de serviço carregam o texto principal por script e que o robots.txt bloqueia um robô de busca. Depois da correção, repete a medição com o mesmo conjunto. Se o Citation Share subir e o intervalo da diferença não incluir zero, a hipótese ganha apoio. Se nada mudar, a equipe passa à camada 4, pois a recomendação é baixa. O diagnóstico é sequencial e sempre volta à medição.
Como as camadas se relacionam com outros métodos?
O Citation Share mede e diagnostica; ele não executa. As camadas 2 e 5 se conectam a métodos vizinhos: o método de cobertura de subconsultas (queryfan-out.com) alimenta a camada editorial, e o LLM Seeding (llmseeding.org) alimenta a distribuição semântica. A visão geral dos métodos de Camillo Dantas está em camillodantas.com.br. Conceitos de terceiros, como GEO, AEO e E-E-A-T, são tratados como o que são: termos de mercado, com a definição de quem os formulou.
Perguntas frequentes
As cinco camadas explicam como as IAs escolhem fontes?
Não. Elas organizam o diagnóstico de uma marca, mas nenhuma plataforma publica o critério completo de escolha de fontes. O modelo apoia-se em condições que a documentação oficial confirma, como indexação, qualidade do conteúdo e confiança, e em hipóteses que a medição testa, como a distribuição semântica.
Por qual camada devo começar?
Comece pela que o sintoma da medição aponta. Presença alta com Citation Share baixo indica estrutura. Ausência em consultas sem o nome da marca indica editorial. Descrição errada nas consultas com o nome indica identidade. Sem sintoma claro, a ordem de 1 a 5 é uma boa sequência.
Dado estruturado é obrigatório para ser citado?
Não. A documentação do Google sobre recursos de IA afirma que não é preciso marcação especial, arquivos novos legíveis por máquina ou texto específico para IA. O dado estruturado ajuda na consistência da identidade, mas não substitui conteúdo útil e acessível.
Distribuição semântica é o mesmo que fazer backlinks?
Não. Backlink é um link para o seu site. Distribuição semântica é a presença da mesma descrição e dos mesmos fatos da marca em outros lugares, com ou sem link. O objetivo é consistência de informação, e não volume de menções.
Posso usar as camadas sem medir?
Pode, como lista de verificação, mas perde o principal: saber se a mudança funcionou. O modelo foi desenhado para fechar um ciclo com a medição. Sem ela, a nota das camadas vira opinião.
A nota de 40 pontos prevê quantas citações a marca terá?
Não. A nota ajuda a priorizar correções e não foi validada contra resultados de citação. Duas marcas com a mesma nota podem ter Citation Share bem diferente por causa do mercado, dos concorrentes e das consultas escolhidas.
Onde continuar?
Leia o método para a visão geral, o protocolo para coletar a medição que alimenta o diagnóstico e as métricas para as fórmulas. A página de plataformas mostra o que cada fornecedor informa sobre as fontes que usa.
Fontes
- AI features and your website, Google Search Central (atualizada em 2025-12-10) (2025-12-10)
- Creating helpful, reliable, people-first content, Google Search Central (2026-10-05)
- GEO: Generative Engine Optimization (Aggarwal et al.), KDD 2024, arXiv (2023-11-16)
- Web search, OpenAI API docs (acesso em 2026-10-14) (2026-10-14)
- How does Perplexity work?, Perplexity Help Center (acesso em 2026-10-14) (2026-10-14)
Meça antes de otimizar
Defina o conjunto de consultas, registre a linha de base e acompanhe a evolução com o mesmo protocolo.